RAG (Retrieval-Augmented Generation) là công nghệ đang được ứng dụng rộng rãi trong lĩnh vực trí tuệ nhân tạo, đặc biệt ở các hệ thống chatbot, trợ lý ảo và ứng dụng AI dành cho doanh nghiệp. Thay vì chỉ dựa vào kiến thức có sẵn trong quá trình huấn luyện, RAG cho phép mô hình AI tìm kiếm thông tin từ những nguồn dữ liệu bên ngoài trước khi tạo câu trả lời.
Nhờ cơ chế này, AI có thể phản hồi sát với tài liệu thực tế, cập nhật kiến thức linh hoạt và hạn chế tình trạng tạo ra thông tin không chính xác. Hãy cùng Blog Phần Mềm tìm hiểu về RAG là gì qua bài viết dưới đây.
RAG là gì?
RAG (Retrieval-Augmented Generation) là phương pháp kết hợp giữa công nghệ truy xuất thông tin (Information Retrieval) và mô hình ngôn ngữ lớn (Large Language Model – LLM) để cải thiện chất lượng câu trả lời do AI tạo ra.
Thuật ngữ Retrieval-Augmented Generation có thể hiểu là tạo sinh được tăng cường bằng khả năng truy xuất dữ liệu. Công nghệ này cho phép mô hình ngôn ngữ tham khảo thêm thông tin từ các nguồn bên ngoài như tài liệu PDF, website, cơ sở dữ liệu, hệ thống quản lý nội bộ hoặc API trước khi phản hồi người dùng.
Để dễ hình dung, hãy tưởng tượng bạn đang hỏi một chatbot về chính sách nghỉ phép của công ty. Nếu chatbot chỉ sử dụng kiến thức được huấn luyện trước đó, nó có thể không biết quy định mới nhất của doanh nghiệp.
Với RAG, hệ thống sẽ tìm kiếm trong kho tài liệu nhân sự, lấy ra nội dung liên quan đến chính sách nghỉ phép rồi chuyển thông tin đó cho LLM. Mô hình sẽ dựa trên tài liệu vừa tìm được để tổng hợp câu trả lời.
Điểm quan trọng là RAG không yêu cầu phải huấn luyện lại toàn bộ mô hình mỗi khi doanh nghiệp cập nhật tài liệu. Thay vào đó, hệ thống chỉ cần cập nhật nguồn dữ liệu được sử dụng để truy xuất.
Vì sao RAG ra đời và giải quyết vấn đề gì của AI?
Các mô hình ngôn ngữ lớn như ChatGPT có khả năng xử lý ngôn ngữ tự nhiên, phân tích câu hỏi và tạo nội dung rất tốt. Tuy nhiên, chúng vẫn tồn tại một số hạn chế khi được sử dụng trong những môi trường yêu cầu thông tin chuyên biệt.
- Thứ nhất, kiến thức của mô hình có giới hạn. LLM được huấn luyện trên một tập dữ liệu nhất định. Những thông tin mới phát sinh sau thời điểm huấn luyện có thể chưa được cập nhật đầy đủ.
- Thứ hai, AI có thể gặp hiện tượng Hallucination. Đây là tình trạng mô hình tạo ra thông tin sai lệch nhưng diễn đạt rất tự tin. Vấn đề này đặc biệt đáng lo ngại khi chatbot được sử dụng để tư vấn sản phẩm, giải đáp chính sách hoặc hỗ trợ nghiệp vụ.
- Thứ ba, AI khó tiếp cận dữ liệu riêng của doanh nghiệp. Những thông tin như báo cáo kinh doanh, quy trình vận hành, tài liệu kỹ thuật hay dữ liệu khách hàng thường không nằm trong tập dữ liệu huấn luyện công khai.
RAG được phát triển để giải quyết những vấn đề trên bằng cách kết nối LLM với nguồn tri thức bên ngoài. Nhờ đó, doanh nghiệp có thể xây dựng ứng dụng AI dựa trên dữ liệu của chính mình mà không cần phát triển một mô hình ngôn ngữ mới từ đầu.
RAG hoạt động như thế nào?
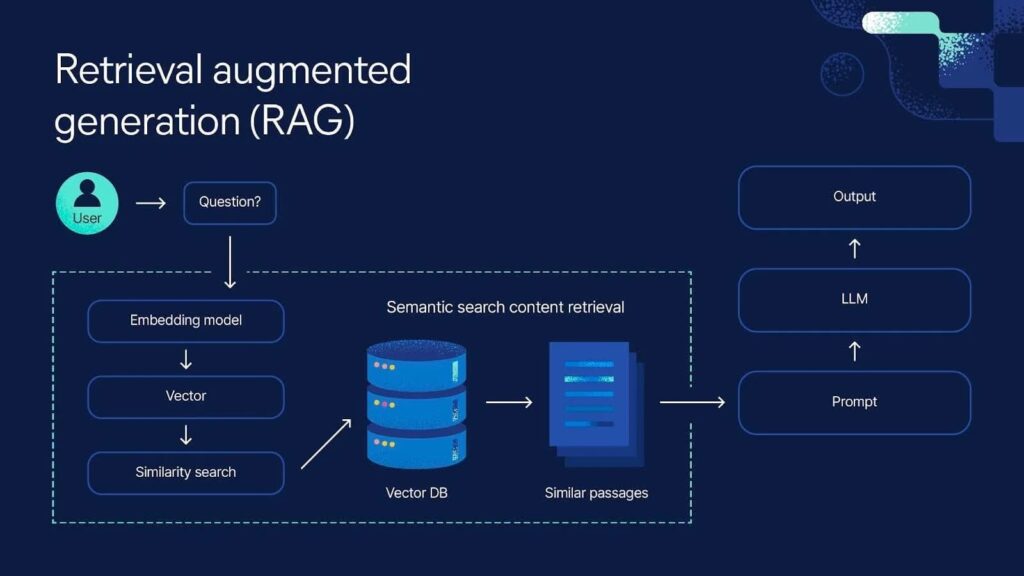
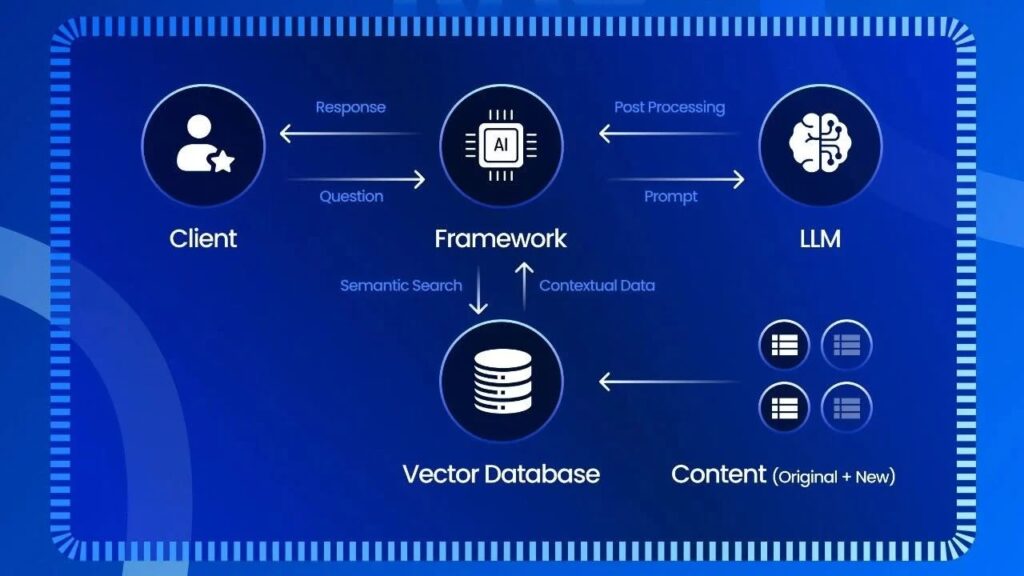
Một hệ thống RAG thường vận hành theo quy trình gồm hai giai đoạn chính: chuẩn bị dữ liệu và xử lý câu hỏi của người dùng. Ở giai đoạn chuẩn bị, hệ thống thu thập tài liệu, xử lý nội dung, chuyển đổi dữ liệu thành vector và lưu trữ trong cơ sở dữ liệu phù hợp. Khi người dùng đặt câu hỏi, hệ thống sẽ tìm kiếm những thông tin liên quan rồi chuyển chúng đến LLM để tạo câu trả lời.
Quy trình cụ thể có thể chia thành các bước sau:
Bước 1: Thu thập và xử lý dữ liệu (Data Ingestion)
Hệ thống tiếp nhận dữ liệu từ nhiều nguồn như tài liệu Word, PDF, website, cơ sở dữ liệu SQL hoặc các hệ thống quản lý nội bộ.
Dữ liệu sau khi thu thập cần được làm sạch, loại bỏ nội dung trùng lặp, xử lý định dạng và chuẩn hóa trước khi đưa vào hệ thống. Đây là bước quan trọng vì chất lượng dữ liệu đầu vào ảnh hưởng trực tiếp đến khả năng truy xuất sau này.
Bước 2: Chia nhỏ tài liệu (Chunking)
Những tài liệu dài thường được chia thành nhiều đoạn nhỏ gọi là Chunk. Việc này giúp hệ thống tìm đúng phần nội dung cần thiết thay vì phải đưa toàn bộ tài liệu vào mô hình AI.
Ví dụ, một tài liệu hướng dẫn sử dụng sản phẩm dài 100 trang có thể được chia thành nhiều đoạn theo từng chương, mục hoặc chủ đề. Khi người dùng hỏi về cách bảo hành, hệ thống chỉ cần truy xuất những đoạn liên quan đến chính sách bảo hành.
Bước 3: Chuyển đổi dữ liệu thành vector (Embedding)
Sau khi chia nhỏ, từng đoạn nội dung được chuyển thành dạng vector thông qua mô hình Embedding. Vector là biểu diễn số học của dữ liệu, giúp máy tính có thể so sánh mức độ tương đồng về ngữ nghĩa giữa các đoạn văn bản. Những nội dung có ý nghĩa gần nhau thường có biểu diễn vector gần nhau trong không gian tìm kiếm.
Bước 4: Lưu trữ trong Vector Database
Các vector sau khi tạo được lưu vào cơ sở dữ liệu vector (Vector Database), đi kèm thông tin và nội dung gốc tương ứng. Một số công nghệ thường được sử dụng gồm Pinecone, Chroma, Weaviate, Milvus và FAISS.
Cơ sở dữ liệu này đóng vai trò như một kho tri thức, giúp hệ thống tìm kiếm nhanh những đoạn thông tin phù hợp với câu hỏi của người dùng.
Bước 5: Truy xuất thông tin (Retrieval)
Khi nhận được câu hỏi, hệ thống sẽ chuyển truy vấn thành vector bằng mô hình Embedding tương ứng. Sau đó, nó tiến hành so sánh với các vector đã lưu trong cơ sở dữ liệu để tìm ra những đoạn nội dung có mức độ liên quan cao.
Bước 6: Tạo câu trả lời (Generation)
Những đoạn dữ liệu được truy xuất sẽ kết hợp với câu hỏi ban đầu để tạo thành một Prompt có đầy đủ ngữ cảnh. LLM tiếp nhận thông tin này, phân tích và tạo ra câu trả lời bằng ngôn ngữ tự nhiên. Một số hệ thống còn cung cấp liên kết hoặc trích dẫn tài liệu gốc để người dùng kiểm tra lại thông tin.
Những thành phần quan trọng trong kiến trúc RAG
Để xây dựng một hệ thống RAG hoàn chỉnh, cần có sự phối hợp của nhiều thành phần công nghệ khác nhau.
| Thành phần | Chức năng |
| LLM | Phân tích ngữ cảnh và tạo câu trả lời |
| Embedding Model | Chuyển văn bản thành vector |
| Vector Database | Lưu trữ và tìm kiếm vector |
| Retriever | Truy xuất dữ liệu liên quan |
| Chunking | Chia tài liệu thành các đoạn nhỏ |
| Reranker | Đánh giá và sắp xếp lại kết quả truy xuất |
| Prompt Engineering | Xây dựng hướng dẫn cho LLM |
Trong đó, Retriever và Reranker có ảnh hưởng lớn đến chất lượng thông tin đầu vào của mô hình. Retriever chịu trách nhiệm tìm kiếm các đoạn dữ liệu tiềm năng, còn Reranker đánh giá lại mức độ phù hợp để chọn ra những kết quả tốt hơn.
Một hệ thống có LLM mạnh nhưng truy xuất sai tài liệu vẫn có thể tạo ra câu trả lời thiếu chính xác. Vì vậy, chất lượng của RAG không phụ thuộc hoàn toàn vào mô hình ngôn ngữ.
Các loại RAG phổ biến hiện nay
Tùy theo mục tiêu triển khai và mức độ phức tạp, RAG được phát triển thành nhiều kiến trúc khác nhau.
Naive RAG
Đây là phiên bản cơ bản nhất, sử dụng quy trình truy xuất dữ liệu, bổ sung ngữ cảnh và tạo câu trả lời. Naive RAG phù hợp với những ứng dụng hỏi đáp tài liệu đơn giản, chatbot nội bộ hoặc hệ thống tra cứu thông tin có phạm vi dữ liệu không quá lớn.
Advanced RAG
Advanced RAG bổ sung các kỹ thuật tối ưu như tìm kiếm kết hợp (Hybrid Search), lọc dữ liệu, truy xuất nhiều bước và Reranking. Mục tiêu là nâng cao chất lượng tài liệu được tìm thấy, giảm thông tin nhiễu và cải thiện độ chính xác của phản hồi.
Modular RAG
Modular RAG sử dụng kiến trúc linh hoạt với các thành phần có thể thay đổi hoặc kết hợp tùy theo nhu cầu. Doanh nghiệp có thể bổ sung nhiều bộ truy xuất, mô hình xử lý và cơ chế đánh giá khác nhau mà không phải thiết kế lại toàn bộ hệ thống.
Graph RAG
Graph RAG kết hợp khả năng truy xuất tài liệu với Knowledge Graph (đồ thị tri thức). Thay vì chỉ tìm kiếm những đoạn văn có nội dung tương đồng, hệ thống còn khai thác mối quan hệ giữa các thực thể và thông tin trong dữ liệu.
Cách tiếp cận này phù hợp với những bài toán cần phân tích mối liên hệ phức tạp, chẳng hạn như nghiên cứu khoa học, tài chính hoặc quản trị tri thức doanh nghiệp.
Agentic RAG
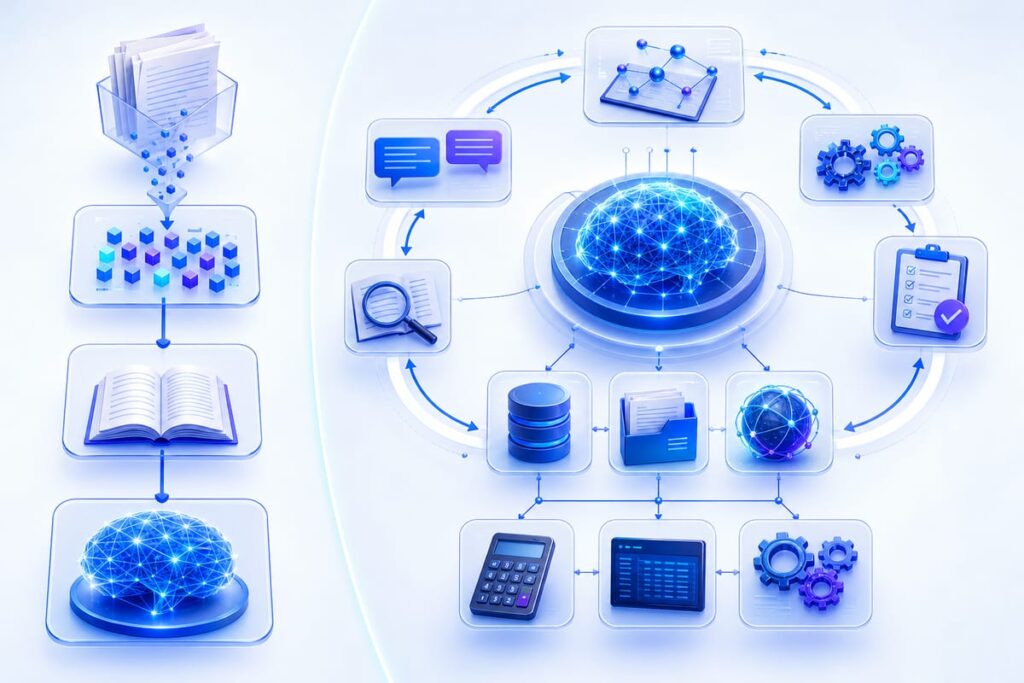
Agentic RAG kết hợp RAG với AI Agent, cho phép hệ thống chủ động lập kế hoạch, thực hiện nhiều lần truy xuất và đánh giá kết quả trước khi đưa ra phản hồi cuối cùng. Đây là hướng phát triển đáng chú ý khi các ứng dụng AI cần xử lý những nhiệm vụ phức tạp hơn.
RAG được ứng dụng như thế nào trong thực tế?
Nhờ khả năng kết nối LLM với nguồn dữ liệu riêng, RAG có thể được triển khai trong nhiều lĩnh vực khác nhau.
- Chăm sóc khách hàng: Chatbot có thể tra cứu thông tin sản phẩm, chính sách đổi trả, bảo hành và hướng dẫn sử dụng để phản hồi khách hàng.
- Quản trị doanh nghiệp: Nhân viên có thể hỏi AI về quy trình nội bộ, chính sách nhân sự, tài liệu đào tạo hoặc báo cáo nghiệp vụ.
- Y tế: Hệ thống có thể hỗ trợ nhân viên chuyên môn tra cứu tài liệu y khoa, hướng dẫn và nghiên cứu liên quan. Nội dung trả lời vẫn cần được chuyên gia kiểm chứng.
- Tài chính và pháp lý: RAG hỗ trợ tìm kiếm hợp đồng, văn bản pháp luật, báo cáo và hồ sơ nghiệp vụ.
- Giáo dục: Học sinh, sinh viên có thể sử dụng chatbot để tra cứu nội dung bài giảng, giáo trình và tài liệu học tập.
- Thương mại điện tử: AI có thể tìm kiếm thông tin sản phẩm, so sánh thông số và tư vấn dựa trên dữ liệu danh mục hàng hóa.
Ví dụ, một website thương mại điện tử có hàng nghìn sản phẩm có thể tích hợp RAG để xây dựng trợ lý mua sắm. Khi khách hàng hỏi về một chiếc laptop có RAM 16GB, hệ thống sẽ truy xuất thông tin từ danh mục sản phẩm rồi tổng hợp những lựa chọn phù hợp thay vì tự suy đoán cấu hình.
RAG có hạn chế gì không?
Mặc dù mang lại nhiều lợi ích, RAG không phải giải pháp có thể loại bỏ hoàn toàn những sai sót của AI. Một trong những hạn chế lớn nhất là chất lượng truy xuất phụ thuộc vào dữ liệu nguồn. Nếu tài liệu bị lỗi, thiếu thông tin hoặc chưa được cập nhật, hệ thống vẫn có thể đưa ra câu trả lời không chính xác.
Ngoài ra, việc chia nhỏ tài liệu không hợp lý có thể làm mất ngữ cảnh. Một đoạn văn bị tách khỏi phần tiêu đề hoặc nội dung giải thích phía trước đôi khi khiến mô hình hiểu sai ý nghĩa ban đầu.
RAG cũng phát sinh chi phí vận hành liên quan đến lưu trữ, Embedding, truy xuất dữ liệu và sử dụng API của LLM. Khi lượng truy vấn tăng cao, doanh nghiệp cần tối ưu hạ tầng để đảm bảo tốc độ phản hồi.
Một vấn đề khác cần quan tâm là bảo mật. Nếu không thiết lập phân quyền phù hợp, hệ thống có thể truy xuất nhầm tài liệu nội bộ mà người dùng không được phép xem. Do đó, triển khai RAG cần đi kèm quy trình kiểm soát chất lượng dữ liệu, phân quyền truy cập và đánh giá kết quả thường xuyên.
RAG và Fine-tuning khác nhau như thế nào?
RAG và Fine-tuning đều là những phương pháp giúp cải thiện khả năng của mô hình AI, nhưng cách tiếp cận hoàn toàn khác nhau.
| Tiêu chí | RAG | Fine-tuning |
| Cơ chế | Truy xuất dữ liệu bên ngoài | Huấn luyện bổ sung mô hình |
| Cập nhật kiến thức | Thay đổi kho dữ liệu | Cần huấn luyện lại khi muốn thay đổi kiến thức đã học |
| Chi phí | Phụ thuộc hạ tầng truy xuất và LLM | Phụ thuộc tài nguyên và quy mô huấn luyện |
| Dữ liệu riêng | Có thể kết nối trực tiếp | Đưa vào tập dữ liệu huấn luyện |
| Khả năng dẫn nguồn | Có thể trích dẫn tài liệu truy xuất | Không mặc định có khả năng dẫn nguồn |
| Mục tiêu phù hợp | Cung cấp thông tin chuyên biệt, cập nhật | Điều chỉnh hành vi, phong cách hoặc năng lực mô hình |
Nếu doanh nghiệp muốn xây dựng chatbot có khả năng tra cứu chính sách mới nhất, RAG thường là lựa chọn phù hợp. Trong khi đó, Fine-tuning hữu ích khi cần điều chỉnh cách mô hình phản hồi, định dạng đầu ra hoặc thực hiện một nhiệm vụ chuyên biệt.
Hai phương pháp này cũng có thể kết hợp với nhau trong cùng một hệ thống để tận dụng ưu điểm của từng công nghệ.
RAG có phải là nền tảng cho thế hệ AI Agent tiếp theo?
Một hướng phát triển đáng chú ý của RAG là khả năng kết hợp với Agentic AI. Trong hệ thống RAG truyền thống, quy trình thường diễn ra theo một luồng tương đối cố định: nhận câu hỏi, tìm kiếm dữ liệu và tạo câu trả lời. Tuy nhiên, khi kết hợp với AI Agent, hệ thống có thể chủ động phân tích yêu cầu, xác định nguồn dữ liệu cần tìm và thực hiện nhiều lượt truy xuất khác nhau.
Ví dụ, khi người dùng yêu cầu phân tích doanh thu của một doanh nghiệp trong ba năm gần nhất, hệ thống Agentic RAG có thể thực hiện lần lượt các công việc:
- Xác định những báo cáo tài chính cần sử dụng.
- Truy xuất dữ liệu doanh thu từ từng năm.
- Đối chiếu các số liệu giữa những tài liệu khác nhau.
- Tìm kiếm thêm thông tin nếu dữ liệu chưa đầy đủ.
- Tổng hợp kết quả và trình bày báo cáo theo yêu cầu.
Nhờ đó, AI có thể xử lý những nhiệm vụ nhiều bước thay vì chỉ trả lời một câu hỏi đơn lẻ. Đây cũng là lý do RAG ngày càng được quan tâm trong quá trình phát triển trợ lý AI và hệ thống tự động hóa doanh nghiệp.
Kết luận
RAG (Retrieval-Augmented Generation) là phương pháp kết hợp khả năng truy xuất dữ liệu bên ngoài với sức mạnh tạo sinh của mô hình ngôn ngữ lớn. Công nghệ này giúp AI tiếp cận nguồn tri thức chuyên biệt, cập nhật thông tin linh hoạt và tạo ra những câu trả lời có căn cứ hơn.
Từ chatbot chăm sóc khách hàng đến hệ thống quản trị tri thức nội bộ, RAG đang mở ra nhiều hướng ứng dụng thực tế cho cá nhân và doanh nghiệp. Tuy nhiên, hiệu quả triển khai vẫn phụ thuộc vào chất lượng dữ liệu, kiến trúc truy xuất và khả năng kiểm soát đầu ra của mô hình. Khi được xây dựng đúng cách, RAG có thể trở thành một thành phần quan trọng trong hệ sinh thái AI hiện đại.